Encode Media Latent
調用擴散管線的 VAE 編碼器 (VAE Encoder) 將實體影像或視訊壓縮編碼為潛在空間張量,供下游擴散去噪節點執行圖生圖 (Image-to-Image) 或視訊生視訊 (Video-to-Video) 任務。
類別目錄:ModularDiffusion/Encode\Decode
核心速覽
- 輸入埠具備動態自我調適能力:連線純影像管線時顯示為
image,連線視訊管線時(LTX、LTX2、WAN 等)則自動切換為input_video。 - 產生的潛在張量經過標準化與解包處理——其維度規格與 Create Noise Latents 產出的張量完全相容,可直接串接各類潛在張量代數與遮罩合成節點。
- 與下游 Generate Media Latents 節點的
add_noise=True搭配使用可實現經典的圖生圖重繪。重繪強度由該節點的start_step與總步數精確計算決定:strength = 1 − (start_step / num_inference_steps)。以總步數num_inference_steps=20為例:start_step=0→ 全噪訊注入(強度 1.0)——完全忽略原圖特徵,行為等同於純文字生圖。start_step=10→ 注入 50% 噪訊(強度 0.5)——在原圖構圖與 AI 創意之間取得極佳平衡。start_step=18→ 注入微量噪訊(強度 0.1)——生成成果高度緊密貼合原圖輪廓。
典型工作流程架構
Load Image → [Encode Media Latent] → Generate Media Latents → Decode Media Latent
節點介面預覽
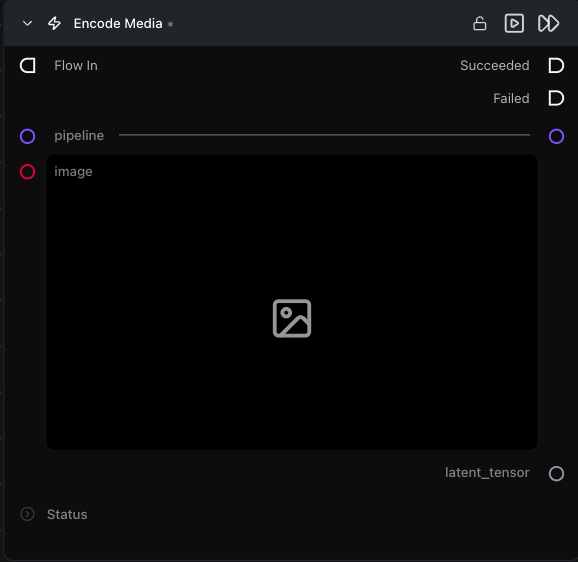
輸入端說明
| 名稱 | 型別 | 必填 | 說明備註 |
|---|---|---|---|
pipeline |
Pipeline Config |
是 | 決定輸入埠插槽呈現為 image 還是 input_video。 |
image |
ImageArtifact / ImageUrlArtifact |
當管線為影像模型時必填 | 欲編碼的來源實體影像。 |
input_video |
VideoArtifact / VideoUrlArtifact |
當管線為視訊模型時必填 | 欲編碼的來源實體視訊。 |
輸出端說明
| 名稱 | 型別 | 說明備註 |
|---|---|---|
latent_tensor |
LatentArtifact |
處於該管線標準潛在空間維度中的編碼完成潛在張量。 |
技巧與避坑指南
- 輸入插槽隨管線型別動態切換:影像管線(Flux、SD3 等)呈現
image埠;視訊管線(LTX、LTX2、WAN 等)則自動替換為input_video埠。若在建立流程中途切換了管線模型架構,請記得重新檢查並連線相應的輸入埠。 - 全新純生成請改用 Create Noise Latents:本節點專門將既有素材編碼入潛在空間以進行局部重繪或風格遷移,絕非用於從零開始的文生圖任務。
相關延伸閱讀
- Encode Masked Media Latent —— 具備遮罩引導的局部重繪專用編碼變體。
- Decode Media Latent —— 將潛在張量還原為實體視覺畫面的逆向解碼運算。
- 工作流程範本:
workflows/templates/Image2Image.py。